
Ta page met 3 secondes à s’afficher et tu soupçonnes la base de données ? Bonne intuition : dans la grande majorité des cas, une application lente cache une requête MySQL lente. Dans ce guide, tu apprends une méthode complète pour la trouver, la comprendre avec EXPLAIN et l’optimiser avec les bons index, en évitant les pièges qui ruinent les performances.
Optimiser une requête MySQL lente n’est pas une question de magie ni de « tuning » obscur du serveur. Dans 9 cas sur 10, le problème vient de la requête elle-même ou d’un index manquant. La bonne nouvelle : MySQL te dit exactement ce qu’il fait, grâce à la commande EXPLAIN. Encore faut-il savoir la lire.
Pour rendre tout ça concret, on va s’appuyer sur un cas réel : la table mesures de notre moniteur système Windows System Dashboard, qui enregistre l’état du PC chaque minute. Après quelques mois, elle dépasse le million de lignes… et l’historique commence à ramer.
1. Trouver les requêtes lentes (slow query log). 2. Les analyser avec EXPLAIN. 3. Corriger : index adapté, réécriture de la requête. 4. Mesurer à nouveau. On ne devine jamais : on mesure.
Étape 1 : trouver la requête MySQL lente
Activer le slow query log
Avant d’optimiser, il faut savoir quoi optimiser. MySQL peut enregistrer dans un fichier toutes les requêtes qui dépassent une durée donnée : c’est le journal des requêtes lentes (slow query log). Active-le à chaud, sans redémarrer :
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 0.5;          -- au-delà de 500 ms
SET GLOBAL log_queries_not_using_indexes = 'ON';

-- Où est le fichier ?
SHOW VARIABLES LIKE 'slow_query_log_file';Pour que le réglage survive à un redémarrage, ajoute-le dans my.ini (Windows / WampServer) ou my.cnf (Linux), section [mysqld] :
[mysqld]
slow_query_log      = 1
slow_query_log_file = "C:/wamp64/logs/mysql-lent.log"
long_query_time = 0.5Laisse tourner ton application quelques heures, puis résume le fichier avec l’outil fourni par MySQL, mysqldumpslow, qui regroupe les requêtes identiques et les trie par temps total :
mysqldumpslow -s t -t 10 "C:\wamp64\logs\mysql-lent.log"Alternative : le Performance Schema
Sur MySQL 8, la vue sys.statements_with_runtimes_in_95th_percentile liste directement les requêtes les plus coûteuses, sans fichier de log :
SELECT query, exec_count, avg_latency, rows_examined_avg
FROM sys.statements_with_runtimes_in_95th_percentile
ORDER BY avg_latency DESC
LIMIT 10;Une requête qui examine 1 million de lignes pour en renvoyer 50 est presque toujours une requête à indexer. Compare toujours lignes examinées et lignes renvoyées.
Étape 2 : comprendre la requête MySQL lente avec EXPLAIN
Prenons la requête de l’historique sur 24 heures :
SELECT horodatage, cpu_pourcentage, memoire_pourcentage
FROM mesures
WHERE horodatage >= NOW() - INTERVAL 24 HOUR
ORDER BY horodatage;Il suffit de la préfixer par EXPLAIN pour obtenir le plan d’exécution, c’est-à-dire la stratégie que MySQL compte utiliser :
EXPLAIN SELECT horodatage, cpu_pourcentage, memoire_pourcentage
FROM mesures
WHERE horodatage >= NOW() - INTERVAL 24 HOUR
ORDER BY horodatage;| id | select_type | table | type | possible_keys | key | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | mesures | ALL | NULL | NULL | 1 003 412 | 33.33 | Using where; Using filesort |
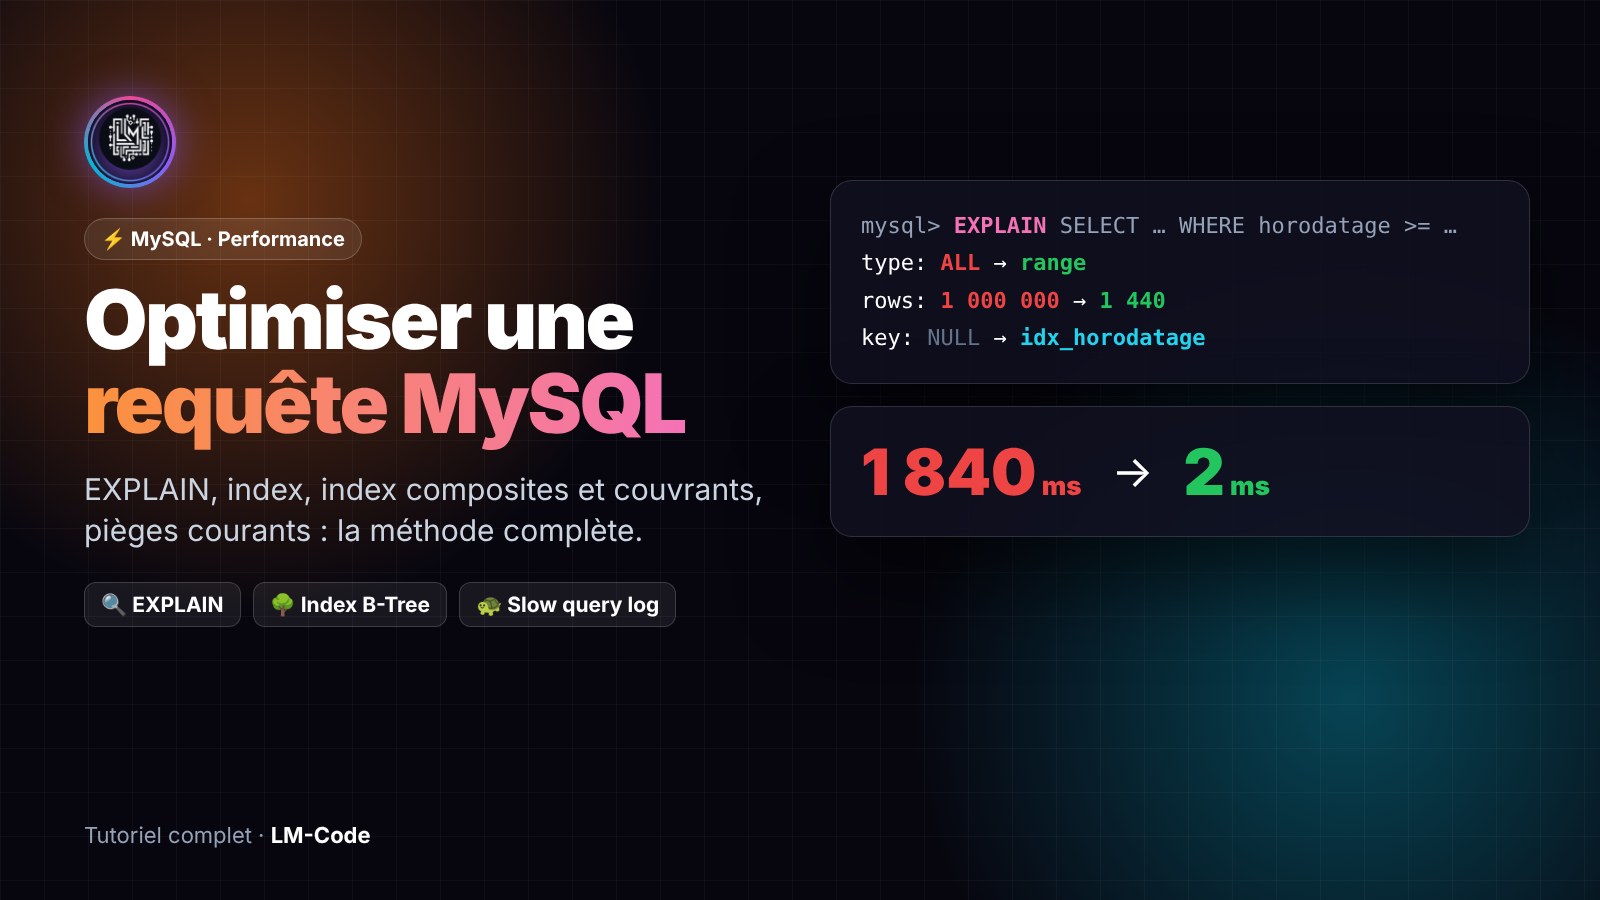
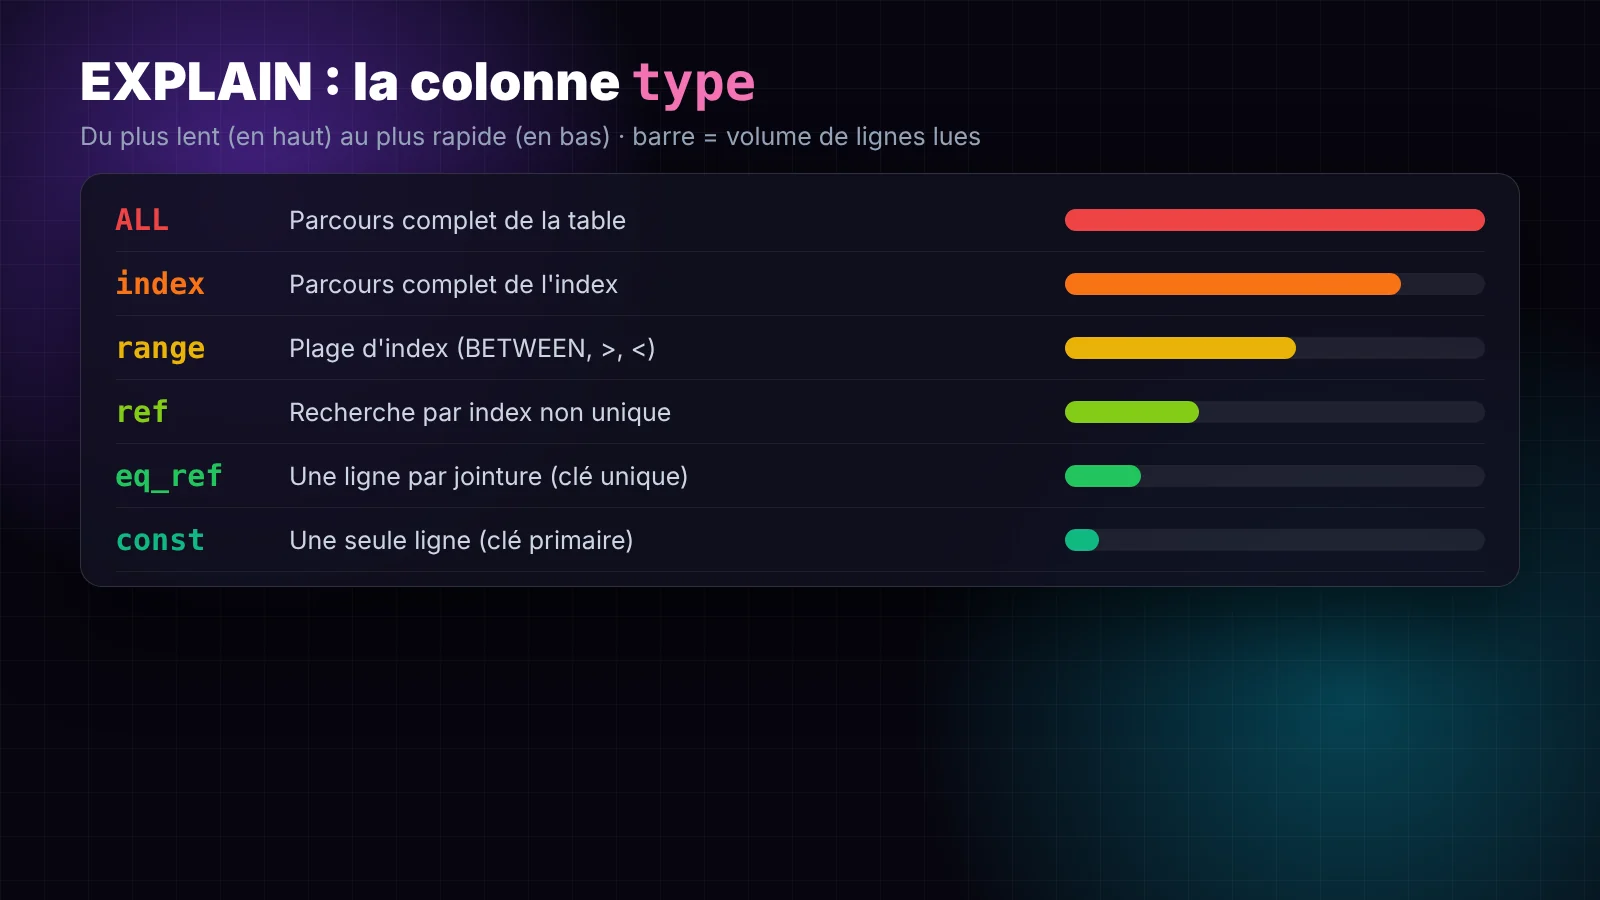
Ce résultat est une alarme rouge : type = ALL (parcours complet de la table), key = NULL (aucun index utilisé), un million de lignes lues et un filesort (tri en mémoire ou sur disque). Voyons comment lire chaque colonne.
Les colonnes d’EXPLAIN qui comptent vraiment
| Colonne | Ce qu’elle indique | Ce qu’on veut voir |
|---|---|---|
type | La méthode d’accès aux lignes | const, eq_ref, ref ou range. Jamais ALL sur une grosse table |
possible_keys | Les index envisageables | Au moins un index |
key | L’index réellement choisi | Pas NULL |
key_len | Combien d’octets de l’index sont utilisés | Plus c’est long, plus de colonnes d’un index composite servent |
rows | Estimation des lignes examinées | Le plus proche possible du nombre de lignes renvoyées |
filtered | % des lignes gardées après la condition | Proche de 100 |
Extra | Détails importants | Using index ✅ ; Using filesort / Using temporary ⚠️ |
EXPLAIN ANALYZE : le temps réel, ligne par ligne
Depuis MySQL 8.0.18, EXPLAIN ANALYZE exécute réellement la requête et affiche, pour chaque étape, le temps mesuré et le nombre de lignes réellement traitées. C’est l’outil idéal pour repérer l’étape qui coûte cher :
EXPLAIN ANALYZE
SELECT horodatage, cpu_pourcentage
FROM mesures
WHERE horodatage >= NOW() - INTERVAL 24 HOUR;

-- -> Filter: (mesures.horodatage >= <cache>((now() - interval 24 hour)))
--      (cost=101234 rows=334470) (actual time=0.09..1838.2 rows=1440 loops=1)
-- -> Table scan on mesures (actual time=0.07..1702.6 rows=1003412 loops=1)Sur un UPDATE ou un DELETE, utilise-le sur une copie de la base. Et sur une requête de 2 minutes… il mettra 2 minutes.
Étape 3 : accélérer la requête MySQL lente avec le bon index
Comment fonctionne un index MySQL ?
Un index InnoDB est un arbre B+ (B-Tree) trié. Comme l’index alphabétique à la fin d’un livre, il permet de trouver une valeur en quelques sauts au lieu de lire toutes les pages. Sur un million de lignes, un arbre B-Tree n’a que 3 ou 4 niveaux : MySQL trouve n’importe quelle valeur en lisant 3 ou 4 pages.
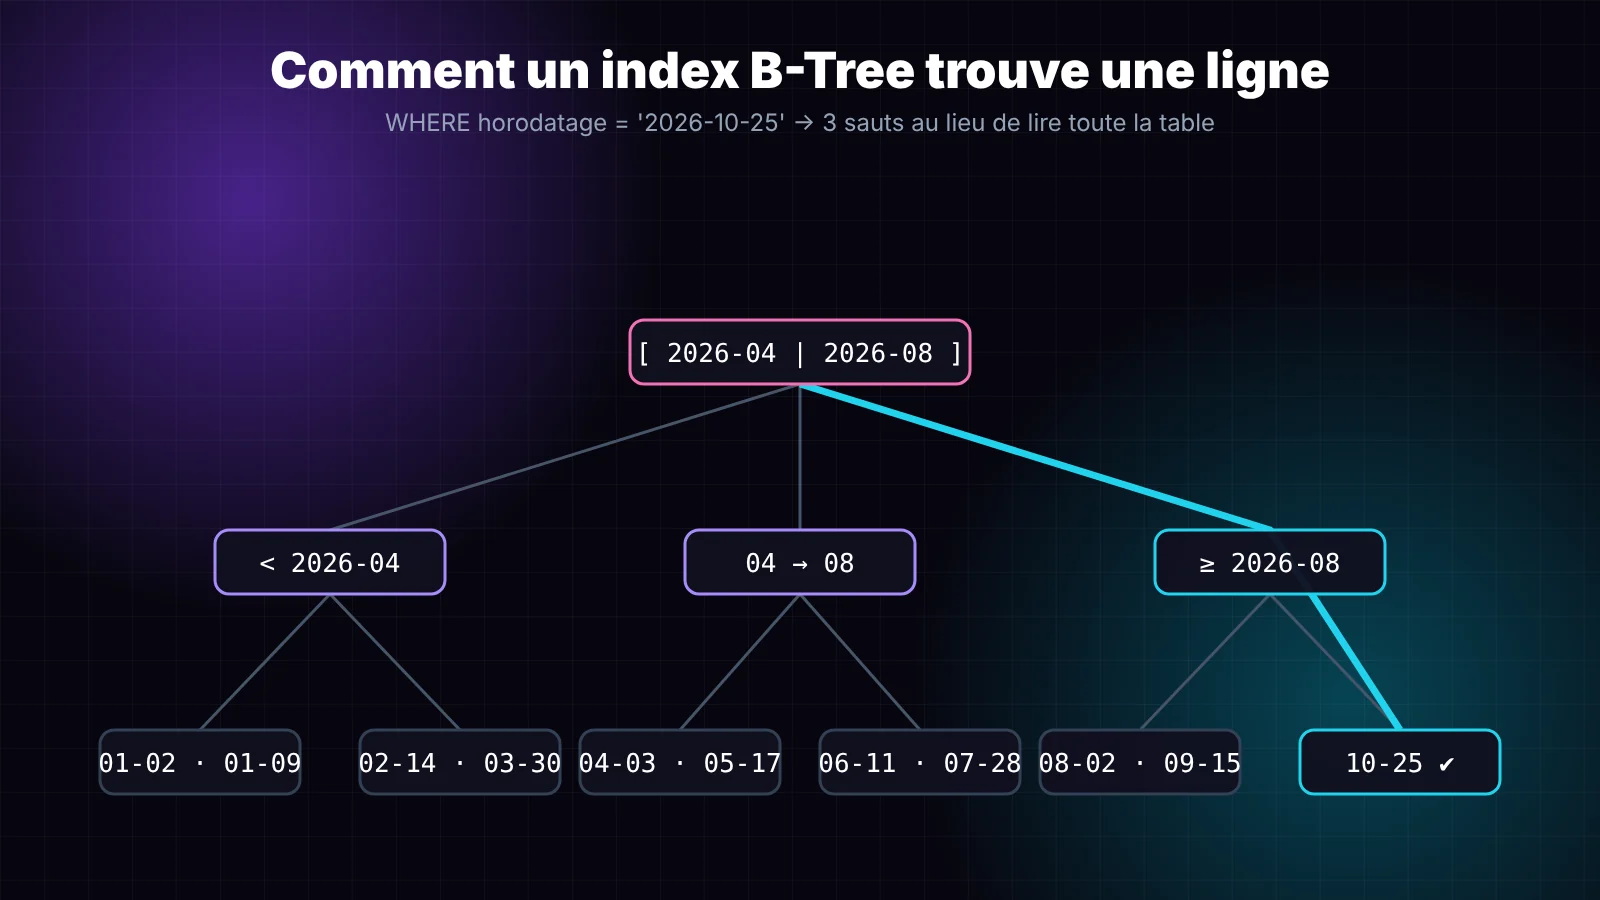
CREATE INDEX idx_mesures_horodatage ON mesures (horodatage);On relance EXPLAIN :
| type | key | rows | Extra |
|---|---|---|---|
| range | idx_mesures_horodatage | 1 440 | Using index condition |
Le filesort a disparu : comme l’index est déjà trié par horodatage, MySQL lit les lignes dans le bon ordre. On est passé d’un million de lignes examinées à 1 440, et de 1,8 seconde à 6 millisecondes.
Les index composites et la règle du préfixe gauche
Un index peut porter sur plusieurs colonnes. L’ordre des colonnes est crucial : MySQL ne peut utiliser un index composite qu’à partir de sa colonne la plus à gauche. C’est la règle du préfixe gauche.
CREATE INDEX idx_commandes_client_date ON commandes (client_id, date_commande);| Requête | Index utilisé ? |
|---|---|
WHERE client_id = 7 | ✅ Oui (préfixe gauche) |
WHERE client_id = 7 AND date_commande >= '2026-01-01' | ✅ Oui, les deux colonnes |
WHERE client_id = 7 ORDER BY date_commande | ✅ Oui, et sans filesort |
WHERE date_commande >= '2026-01-01' | ❌ Non : la première colonne manque |
D’abord les colonnes testées par égalité (=, IN), ensuite une seule colonne de plage (>, BETWEEN, LIKE 'abc%') ou de tri. Après une condition de plage, les colonnes suivantes de l’index ne servent plus au filtrage.
L’index couvrant : la requête MySQL ne touche même plus la table
Si l’index contient toutes les colonnes dont la requête a besoin, MySQL répond directement depuis l’index, sans lire les lignes de la table. EXPLAIN affiche alors Using index :
CREATE INDEX idx_mesures_historique
    ON mesures (horodatage, cpu_pourcentage, memoire_pourcentage);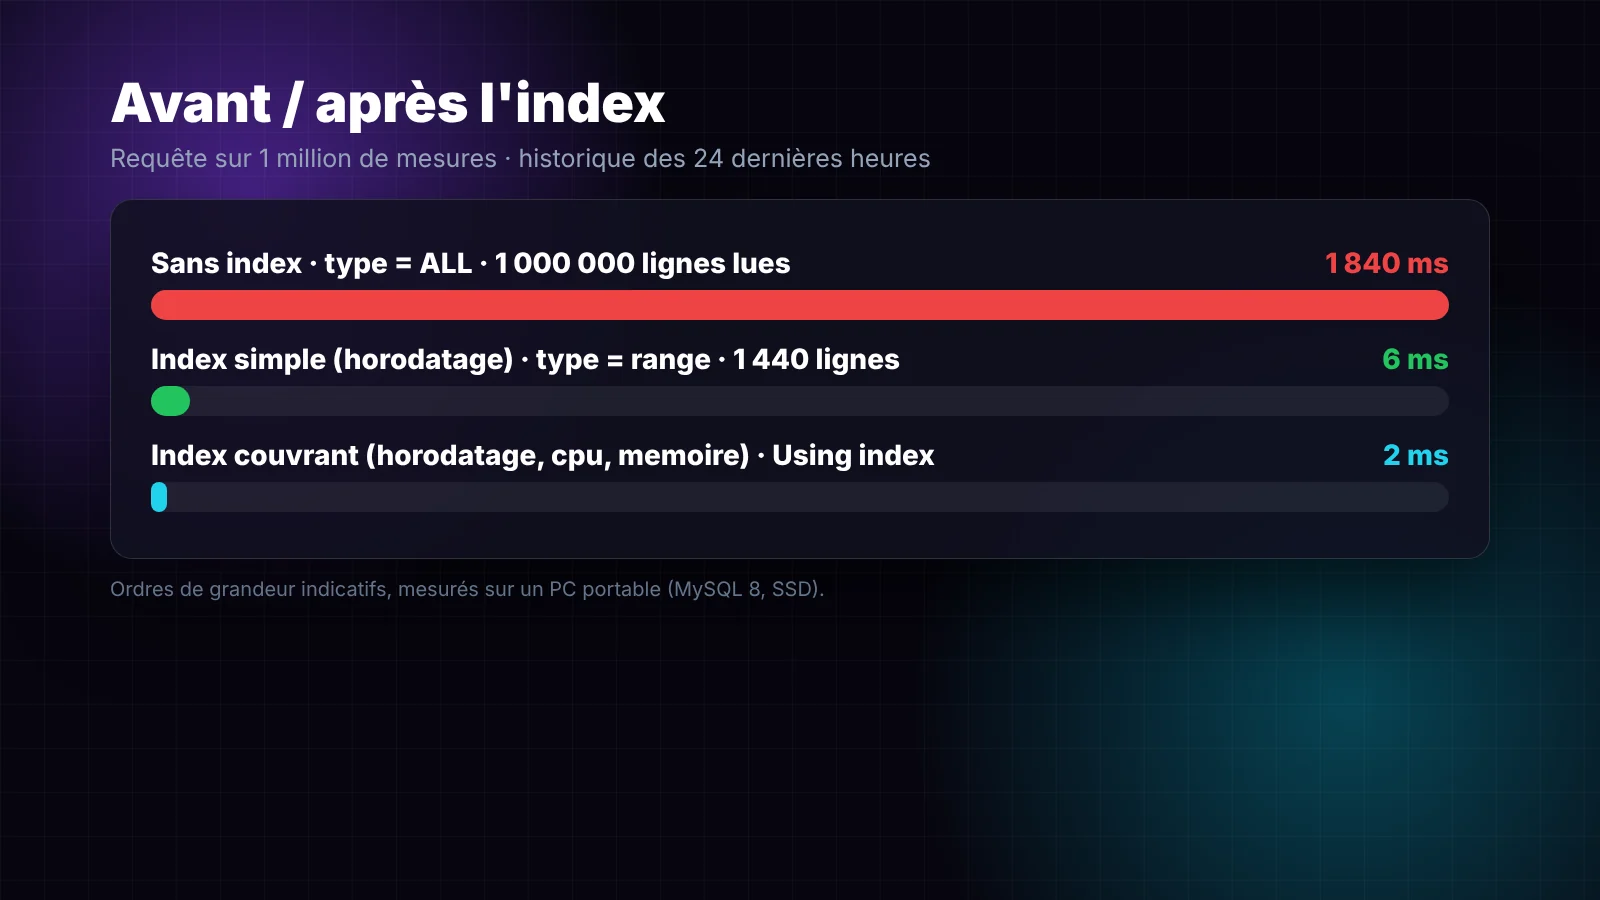
Chaque index ralentit les INSERT, UPDATE et DELETE et occupe de la place. Indexe les colonnes de tes WHERE, JOIN et ORDER BY fréquents, pas « tout au cas où ». Supprime les index inutilisés (vue sys.schema_unused_indexes).
Les pièges qui transforment une requête en requête MySQL lente
Tu as créé l’index… et EXPLAIN affiche toujours ALL ? C’est presque toujours l’un de ces pièges.
Piège 1 : une fonction sur la colonne indexée
-- ❌ L'index sur horodatage est ignoré : MySQL doit calculer DATE() pour chaque ligne
SELECT * FROM mesures WHERE DATE(horodatage) = '2026-10-25';

-- ✅ Réécrire en plage : l'index est utilisé (type = range)
SELECT * FROM mesures
WHERE horodatage >= '2026-10-25' AND horodatage < '2026-10-26';Même principe pour YEAR(date), LOWER(email) ou prix * 1.21 > 100. Garde la colonne « nue » d’un côté de la comparaison. Sur MySQL 8.0.13+, tu peux aussi créer un index fonctionnel : CREATE INDEX idx_email ON users ((LOWER(email)));
Piège 2 : LIKE avec un joker au début
-- ❌ Impossible d'utiliser un index B-Tree
SELECT * FROM produits WHERE nom LIKE '%clavier%';

-- ✅ Préfixe connu : index utilisé
SELECT * FROM produits WHERE nom LIKE 'clavier%';

-- ✅ Recherche plein texte : index FULLTEXT
ALTER TABLE produits ADD FULLTEXT INDEX ft_nom (nom);
SELECT * FROM produits WHERE MATCH(nom) AGAINST('clavier');Piège 3 : la conversion de type implicite
-- telephone est un VARCHAR indexé
-- ❌ Comparé à un nombre : MySQL convertit chaque ligne, index ignoré
SELECT * FROM clients WHERE telephone = 0470123456;

-- ✅ Même type des deux côtés
SELECT * FROM clients WHERE telephone = '0470123456';Le même problème survient lors d’une jointure entre deux colonnes de types ou de collations différents (utf8mb4_general_ci d’un côté, utf8mb4_unicode_ci de l’autre) : vérifie que tes clés étrangères ont exactement le même type que les clés primaires.
Piège 4 : OR sur des colonnes différentes
-- ⚠️ Souvent un parcours complet
SELECT * FROM clients WHERE email = '[email protected]' OR telephone = '0470123456';

-- ✅ Deux requêtes indexées réunies
SELECT * FROM clients WHERE email = '[email protected]'
UNION
SELECT * FROM clients WHERE telephone = '0470123456';Piège 5 : SELECT * et OFFSET géant
SELECT * empêche les index couvrants et transfère des colonnes inutiles (parfois des TEXT énormes). Liste les colonnes dont tu as besoin. Pour la pagination, LIMIT 20 OFFSET 200000 oblige MySQL à lire et jeter 200 000 lignes. Préfère la pagination par curseur (keyset pagination) :
-- ❌ Plus on avance, plus c'est lent
SELECT id, titre FROM articles ORDER BY id DESC LIMIT 20 OFFSET 200000;

-- ✅ Toujours rapide : on repart du dernier id affiché
SELECT id, titre FROM articles
WHERE id < 734512
ORDER BY id DESC
LIMIT 20;Piège 6 : le problème N+1 côté PHP
Parfois, chaque requête est rapide… mais il y en a 500. C’est le problème N+1 : une requête pour la liste, puis une requête par élément dans une boucle. Remplace la boucle par une seule requête avec une jointure SQL ou un WHERE id IN (…) :
<?php
// ❌ 1 requête + 1 requête par commande
$commandes = $pdo->query('SELECT id, client_id FROM commandes LIMIT 100')->fetchAll();
foreach ($commandes as $c) {
    $stmt = $pdo->prepare('SELECT nom FROM clients WHERE id = ?');
    $stmt->execute([$c['client_id']]);
}

// ✅ Une seule requête
$commandes = $pdo->query(
    'SELECT o.id, c.nom
     FROM commandes AS o
     JOIN clients AS c ON c.id = o.client_id
     LIMIT 100'
)->fetchAll();Étape 4 : les autres leviers contre une requête MySQL lente
Mettre à jour les statistiques
MySQL choisit son plan d’exécution grâce à des statistiques sur la distribution des valeurs. Après un gros import ou de nombreuses suppressions, elles peuvent être fausses et pousser l’optimiseur à ignorer un bon index. Rafraîchis-les :
ANALYZE TABLE mesures;Choisir des types de colonnes compacts
Plus une ligne est petite, plus il en tient dans une page mémoire de 16 Ko, et plus les index sont légers. Quelques réflexes : INT UNSIGNED plutôt que BIGINT quand c’est suffisant, TINYINT pour un pourcentage entier, DATETIME plutôt qu’une date stockée en VARCHAR, VARCHAR(100) plutôt que TEXT pour un nom.
Donner de la mémoire à InnoDB
Le paramètre le plus important du serveur est innodb_buffer_pool_size : le cache où InnoDB garde les données et les index en mémoire. La valeur par défaut (128 Mo) est minuscule. Sur un serveur dédié à MySQL, on vise 50 à 70 % de la RAM ; sur un PC de développement, 1 à 2 Go suffisent largement.
[mysqld]
innodb_buffer_pool_size = 1GArchiver ou purger les vieilles données
La requête la plus rapide est celle qui lit le moins de lignes. Le System Dashboard purge automatiquement les mesures de plus de 30 jours ; pour des tables qui doivent tout garder, regarde le partitionnement par date (PARTITION BY RANGE), qui permet à MySQL d’ignorer les partitions hors période.
Checklist : optimiser une requête MySQL lente
- Repérer la requête avec le slow query log ou
sys.statements_with_runtimes_in_95th_percentile. - Lancer
EXPLAIN: vérifiertype,key,rowsetExtra. - Ajouter un index sur les colonnes du
WHERE, duJOINet de l’ORDER BY, dans le bon ordre. - Vérifier qu’aucun piège ne neutralise l’index : fonction,
LIKE '%…', conversion de type,OR. - Ne sélectionner que les colonnes utiles, viser un index couvrant pour les requêtes critiques.
- Remplacer
OFFSETpar une pagination par curseur et éliminer les requêtes N+1. - Mesurer à nouveau avec
EXPLAIN ANALYZE, et garder une trace du gain.
FAQ : requête MySQL lente
Comment savoir pourquoi une requête MySQL est lente ?
Préfixe-la avec EXPLAIN (ou EXPLAIN ANALYZE sur MySQL 8.0.18+). Si la colonne type vaut ALL, si key vaut NULL ou si Extra indique Using filesort ou Using temporary, la requête parcourt trop de lignes et a probablement besoin d’un index.
Que signifie type = ALL dans EXPLAIN ?
Que MySQL lit toute la table, ligne par ligne, pour répondre. C’est acceptable sur une petite table, mais c’est la première cause de lenteur sur une table volumineuse.
Faut-il mettre un index sur toutes les colonnes ?
Non. Chaque index ralentit les écritures et occupe de l’espace. Indexe les colonnes utilisées dans les WHERE, JOIN et ORDER BY de tes requêtes fréquentes, et privilégie des index composites bien ordonnés.
Pourquoi MySQL n’utilise-t-il pas mon index ?
Le plus souvent à cause d’une fonction appliquée à la colonne, d’un LIKE commençant par %, d’une conversion de type implicite, d’un index composite dont la première colonne n’est pas filtrée, ou parce que l’optimiseur estime qu’un parcours complet est moins coûteux sur une petite table.
Comment activer le slow query log sous WampServer ?
Ajoute slow_query_log = 1, slow_query_log_file et long_query_time dans la section [mysqld] du fichier my.ini (clic sur l’icône Wamp, MySQL, my.ini), puis redémarre MySQL.
Conclusion
Optimiser une requête MySQL lente suit toujours la même logique : mesurer, comprendre, corriger, vérifier. Le slow query log te dit où chercher, EXPLAIN te dit pourquoi c’est lent, et un index bien pensé règle la grande majorité des cas. Le reste, ce sont des réflexes : pas de fonction sur une colonne indexée, pas de SELECT * inutile, pas de requêtes N+1.
Pour t’entraîner sur un vrai projet, installe le System Dashboard : sa table mesures grossit d’elle-même, et tu pourras observer l’effet des index sur l’historique de 30 jours. Si tu débutes avec les relations entre tables, commence par notre guide des jointures SQL. Et pour creuser, la page Optimization and Indexes de la documentation MySQL est une mine d’or.