
Combien de commandes par client ? Quel chiffre d’affaires par mois ? Quels produits se vendent plus de 100 fois ? Toutes ces questions se résolvent avec GROUP BY et HAVING. Dans ce guide, tu apprends à regrouper et filtrer tes données SQL avec des exemples concrets sur une vraie base de commandes, les pièges à éviter (dont la fameuse erreur 1055 de MySQL) et des exercices corrigés pour t’entraîner.
Quand tu débutes en SQL, SELECT … FROM … WHERE te permet de lire des lignes. Mais très vite, on te demande des chiffres : le total des ventes, le nombre de clients par ville, la moyenne des notes. C’est là qu’interviennent GROUP BY et HAVING, deux clauses qui transforment ta base de données en véritable outil d’analyse.
Ce guide part de zéro et va jusqu’aux cas avancés. Chaque notion est illustrée sur la même petite base de données, avec le résultat obtenu, pour que tu voies exactement ce que fait chaque requête.
- Les fonctions d’agrégation :
COUNT,SUM,AVG,MIN,MAX. - Regrouper avec
GROUP BY, sur une ou plusieurs colonnes. - La différence fondamentale entre
WHEREetHAVING. - L’ordre d’exécution réel d’une requête SQL.
- Corriger l’erreur MySQL 1055 (
ONLY_FULL_GROUP_BY). - Les techniques avancées :
WITH ROLLUP,GROUP_CONCAT, agrégations conditionnelles.
La base de données d’exemple
On travaille sur une boutique en ligne avec deux tables. Copie ce script dans ton outil SQL (phpMyAdmin, MySQL Workbench, DBeaver…) pour suivre les exemples :
CREATE TABLE clients (
    id INT PRIMARY KEY,
    nom VARCHAR(50) NOT NULL,
    ville VARCHAR(50) NOT NULL
);

CREATE TABLE commandes (
    id INT PRIMARY KEY,
    client_id INT NOT NULL,
    date_commande DATE NOT NULL,
    montant DECIMAL(8,2) NOT NULL,
    statut VARCHAR(20) NOT NULL,
    FOREIGN KEY (client_id) REFERENCES clients(id)
);

INSERT INTO clients VALUES
(1, 'Alice', 'Bruxelles'), (2, 'Bruno', 'Liège'),
(3, 'Chloé', 'Bruxelles'), (4, 'David', 'Namur');

INSERT INTO commandes VALUES
(1, 1, '2026-01-05', 120.00, 'livrée'),
(2, 1, '2026-01-20',  45.50, 'livrée'),
(3, 2, '2026-01-22', 300.00, 'livrée'),
(4, 3, '2026-02-02',  80.00, 'annulée'),
(5, 1, '2026-02-14', 210.00, 'livrée'),
(6, 2, '2026-02-18',  60.00, 'en cours'),
(7, 3, '2026-03-01', 150.00, 'livrée'),
(8, 2, '2026-03-03', 95.00, 'livrée');David (client n°4) n’a passé aucune commande : on s’en servira pour un piège classique.
Les fonctions d’agrégation
Une fonction d’agrégation prend un ensemble de lignes et renvoie une seule valeur. Sans GROUP BY, elle s’applique à toute la table :
SELECT
    COUNT(*)      AS nb_commandes,
    SUM(montant)  AS total,
    AVG(montant)  AS panier_moyen,
    MIN(montant)  AS plus_petite,
    MAX(montant)  AS plus_grosse
FROM commandes;| nb_commandes | total | panier_moyen | plus_petite | plus_grosse |
|---|---|---|---|---|
| 8 | 1060.50 | 132.562500 | 45.50 | 300.00 |
| Fonction | Ce qu’elle calcule | Ignore les NULL ? |
|---|---|---|
COUNT(*) | Le nombre de lignes | Non (compte toutes les lignes) |
COUNT(colonne) | Le nombre de valeurs non nulles | Oui |
COUNT(DISTINCT colonne) | Le nombre de valeurs différentes | Oui |
SUM(colonne) | La somme | Oui |
AVG(colonne) | La moyenne | Oui |
MIN(colonne) / MAX(colonne) | La plus petite / plus grande valeur (aussi pour les dates et les textes) | Oui |
AVG ignore les NULL : la moyenne de 10, 20 et NULL est 15, pas 10. Si une valeur absente doit compter comme zéro, écris AVG(COALESCE(note, 0)).
GROUP BY : un résultat par groupe
GROUP BY découpe les lignes en groupes qui partagent la même valeur, puis applique les fonctions d’agrégation à chaque groupe. Le résultat contient une ligne par groupe.
Combien de commandes et quel total par client ?
SELECT client_id,
       COUNT(*)     AS nb_commandes,
       SUM(montant) AS total
FROM commandes
GROUP BY client_id;| client_id | nb_commandes | total |
|---|---|---|
| 1 | 3 | 375.50 |
| 2 | 3 | 455.00 |
| 3 | 2 | 230.00 |
Ce qui se passe en coulisses :
- MySQL rassemble les lignes du client 1 (commandes 1, 2, 5), celles du client 2 (3, 6, 8) et celles du client 3 (4, 7) ;
- pour chaque groupe, il calcule
COUNT(*)etSUM(montant); - il renvoie une ligne par groupe.
Afficher le nom du client avec une jointure
Un identifiant n’est pas très parlant. On ajoute le nom grâce à une jointure avec la table clients :
SELECT c.nom,
       COUNT(*)       AS nb_commandes,
       SUM(m.montant) AS total
FROM commandes AS m
JOIN clients   AS c ON c.id = m.client_id
GROUP BY c.id, c.nom
ORDER BY total DESC;| nom | nb_commandes | total |
|---|---|---|
| Bruno | 3 | 455.00 |
| Alice | 3 | 375.50 |
| Chloé | 2 | 230.00 |
Deux clients peuvent s’appeler « Alice ». En regroupant par c.nom seul, leurs commandes seraient fusionnées. Regroupe toujours par la clé primaire (c.id) et ajoute les colonnes à afficher.
Regrouper sur plusieurs colonnes
Chaque combinaison de valeurs forme un groupe. Nombre de commandes par client et par statut :
SELECT client_id, statut, COUNT(*) AS nb
FROM commandes
GROUP BY client_id, statut
ORDER BY client_id, statut;| client_id | statut | nb |
|---|---|---|
| 1 | livrée | 3 |
| 2 | en cours | 1 |
| 2 | livrée | 2 |
| 3 | annulée | 1 |
| 3 | livrée | 1 |
Regrouper par période
Pour un chiffre d’affaires mensuel, on regroupe sur une expression calculée à partir de la date :
SELECT DATE_FORMAT(date_commande, '%Y-%m') AS mois,
       COUNT(*)                            AS nb_commandes,
       SUM(montant)                        AS chiffre_affaires
FROM commandes
WHERE statut = 'livrée'
GROUP BY mois
ORDER BY mois;| mois | nb_commandes | chiffre_affaires |
|---|---|---|
| 2026-01 | 3 | 465.50 |
| 2026-02 | 1 | 210.00 |
| 2026-03 | 2 | 245.00 |
MySQL et MariaDB acceptent l’alias mois dans GROUP BY. Ce n’est pas le cas de tous les systèmes : sous SQL Server, il faut répéter l’expression DATE_FORMAT(...). PostgreSQL l’accepte aussi.
HAVING : filtrer les groupes
Et si on ne veut que les clients qui ont dépensé plus de 300 € ? Premier réflexe : utiliser WHERE…
-- ❌ Erreur : on ne peut pas utiliser une fonction d'agrégation dans WHERE
SELECT client_id, SUM(montant) AS total
FROM commandes
WHERE SUM(montant) > 300
GROUP BY client_id;
-- ERROR 1111 (HY000): Invalid use of group functionWHERE filtre les lignes, avant que les groupes n’existent : à ce moment-là, la somme n’a pas encore été calculée. Pour filtrer les groupes, après le calcul, on utilise HAVING :
-- ✅ HAVING filtre les groupes après l'agrégation
SELECT client_id, SUM(montant) AS total
FROM commandes
GROUP BY client_id
HAVING SUM(montant) > 300;| client_id | total |
|---|---|
| 1 | 375.50 |
| 2 | 455.00 |
WHERE ou HAVING : la différence en un tableau
| WHERE | HAVING | |
|---|---|---|
| Filtre… | les lignes | les groupes |
| S’exécute… | avant le regroupement | après le regroupement |
| Fonctions d’agrégation | Interdites | Autorisées |
| Exemple | WHERE statut = 'livrée' | HAVING COUNT(*) >= 3 |
Les deux se combinent très bien. Les clients qui ont au moins deux commandes livrées :
SELECT client_id, COUNT(*) AS nb_livrees
FROM commandes
WHERE statut = 'livrée'      -- 1. on ne garde que les commandes livrées
GROUP BY client_id           -- 2. on regroupe par client
HAVING COUNT(*) >= 2; -- 3. on garde les groupes d'au moins 2 commandes| client_id | nb_livrees |
|---|---|
| 1 | 3 |
| 2 | 2 |
Une condition qui porte sur une colonne (et pas sur un agrégat) doit aller dans WHERE, pas dans HAVING. WHERE réduit le nombre de lignes avant le regroupement, ce qui est beaucoup plus rapide, et peut utiliser les index. HAVING statut = 'livrée' fonctionnerait parfois, mais regrouperait inutilement toutes les lignes avant de les filtrer.
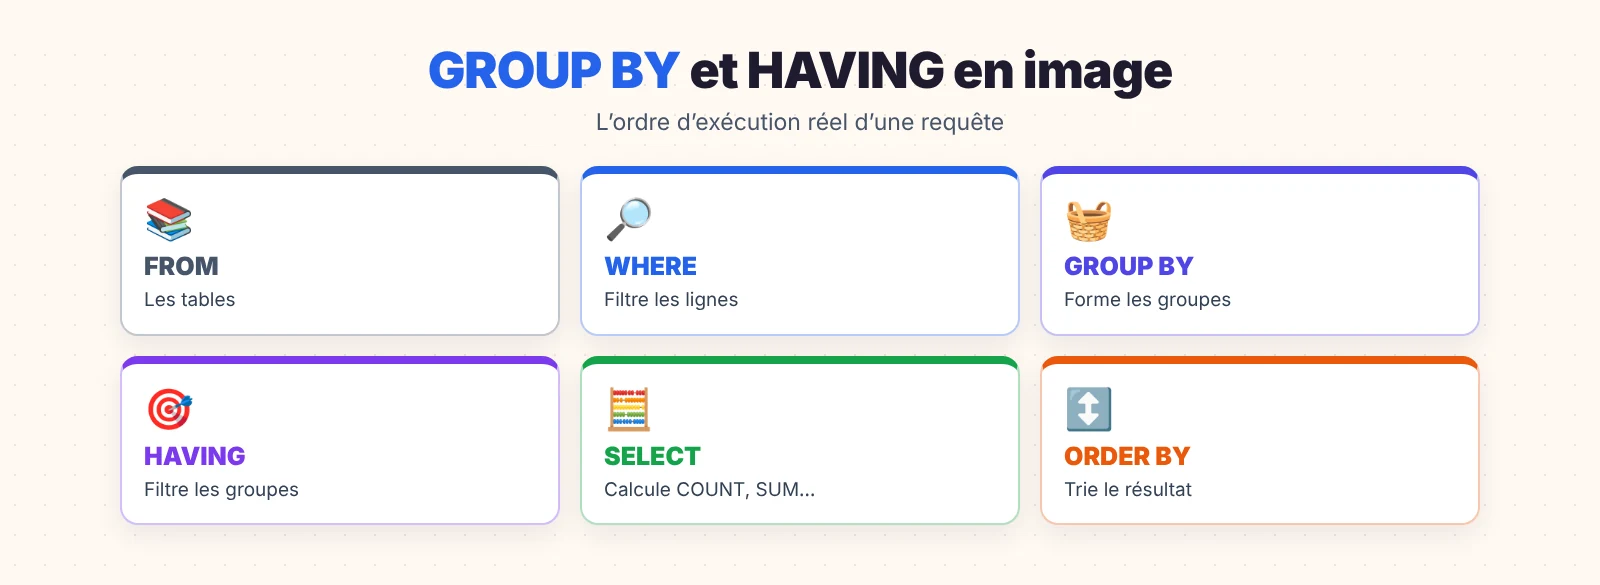
L’ordre d’exécution d’une requête SQL
C’est la clé pour comprendre GROUP BY et HAVING. Tu écris la requête dans un ordre, mais le moteur l’exécute dans un autre :
| Ordre d’écriture | Ordre d’exécution | Étape |
|---|---|---|
1. SELECT | 1. FROM + JOIN | Récupère et assemble les tables |
2. FROM | 2. WHERE | Filtre les lignes |
3. WHERE | 3. GROUP BY | Forme les groupes |
4. GROUP BY | 4. HAVING | Filtre les groupes |
5. HAVING | 5. SELECT | Calcule les colonnes à afficher |
6. ORDER BY | 6. ORDER BY | Trie le résultat |
7. LIMIT | 7. LIMIT | Garde les N premières lignes |
Cet ordre explique tout : pourquoi WHERE ne connaît pas les agrégats (ils n’existent pas encore), et pourquoi les alias du SELECT ne sont, en SQL standard, pas utilisables dans WHERE.
L’erreur MySQL 1055 et ONLY_FULL_GROUP_BY
Tôt ou tard, tu rencontreras cette erreur :
ERROR 1055 (42000): Expression #2 of SELECT list is not in GROUP BY clause
and contains nonaggregated column 'boutique.commandes.date_commande' which is
not functionally dependent on columns in GROUP BY clause; this is incompatible
with sql_mode=only_full_group_byElle vient d’une requête comme celle-ci :
-- ❌ Quelle date afficher ? Le client 1 a TROIS dates différentes
SELECT client_id, date_commande, SUM(montant)
FROM commandes
GROUP BY client_id;Chaque groupe contient plusieurs lignes, donc plusieurs dates. MySQL ne peut pas savoir laquelle tu veux. Avec le mode ONLY_FULL_GROUP_BY (activé par défaut depuis MySQL 5.7), il refuse la requête plutôt que de choisir une date au hasard.
La règle : chaque colonne du SELECT doit être soit dans le GROUP BY, soit dans une fonction d’agrégation. Corrige en précisant ce que tu veux vraiment :
-- ✅ La date de la dernière commande de chaque client
SELECT client_id,
       MAX(date_commande) AS derniere_commande,
       SUM(montant)       AS total
FROM commandes
GROUP BY client_id;Beaucoup de tutoriels conseillent de retirer ONLY_FULL_GROUP_BY du sql_mode. L’erreur disparaît, mais tes requêtes renvoient alors des valeurs arbitraires et tes résultats peuvent être faux sans que tu t’en rendes compte. Corrige la requête : c’est elle qui est ambiguë.
Les pièges classiques de GROUP BY et HAVING
COUNT(\*) et les jointures externes
On veut le nombre de commandes de tous les clients, y compris ceux qui n’ont rien commandé :
SELECT c.nom, COUNT(*) AS nb_commandes   -- ❌ David apparaît avec 1 commande !
FROM clients AS c
LEFT JOIN commandes AS m ON m.client_id = c.id
GROUP BY c.id, c.nom;Avec LEFT JOIN, David a une ligne (avec des NULL à la place de la commande), et COUNT(*) compte les lignes. La correction : compter une colonne de la table de droite, qui vaut NULL pour David.
SELECT c.nom, COUNT(m.id) AS nb_commandes   -- ✅ David : 0
FROM clients AS c
LEFT JOIN commandes AS m ON m.client_id = c.id
GROUP BY c.id, c.nom;| nom | nb_commandes |
|---|---|
| Alice | 3 |
| Bruno | 3 |
| Chloé | 2 |
| David | 0 |
SUM qui renvoie NULL au lieu de 0
Pour David, SUM(m.montant) renvoie NULL (aucune valeur à additionner). Pour afficher 0 :
SELECT c.nom, COALESCE(SUM(m.montant), 0) AS total
FROM clients AS c
LEFT JOIN commandes AS m ON m.client_id = c.id
GROUP BY c.id, c.nom;Les valeurs NULL forment un groupe
Si une colonne de regroupement contient des NULL, toutes ces lignes sont rassemblées dans un même groupe NULL. Pense à le traiter, par exemple avec COALESCE(ville, 'Non renseignée').
Techniques avancées
Des agrégations conditionnelles (tableau croisé)
Combiner SUM et CASE permet de compter plusieurs catégories sur une seule ligne :
SELECT client_id,
       SUM(CASE WHEN statut = 'livrée'   THEN 1 ELSE 0 END) AS livrees,
       SUM(CASE WHEN statut = 'en cours' THEN 1 ELSE 0 END) AS en_cours,
       SUM(CASE WHEN statut = 'annulée'  THEN 1 ELSE 0 END) AS annulees
FROM commandes
GROUP BY client_id;| client_id | livrees | en_cours | annulees |
|---|---|---|---|
| 1 | 3 | 0 | 0 |
| 2 | 2 | 1 | 0 |
| 3 | 1 | 0 | 1 |
GROUP_CONCAT : lister les valeurs d’un groupe
SELECT c.ville,
       COUNT(*)                                       AS nb_clients,
       GROUP_CONCAT(c.nom ORDER BY c.nom SEPARATOR ', ') AS clients
FROM clients AS c
GROUP BY c.ville;| ville | nb_clients | clients |
|---|---|---|
| Bruxelles | 2 | Alice, Chloé |
| Liège | 1 | Bruno |
| Namur | 1 | David |
GROUP_CONCAT est propre à MySQL et MariaDB. Son équivalent est STRING_AGG sous PostgreSQL et SQL Server.
WITH ROLLUP : les sous-totaux et le total général
SELECT statut, COUNT(*) AS nb, SUM(montant) AS total
FROM commandes
GROUP BY statut WITH ROLLUP;| statut | nb | total |
|---|---|---|
| annulée | 1 | 80.00 |
| en cours | 1 | 60.00 |
| livrée | 6 | 920.50 |
| NULL | 8 | 1060.50 |
La dernière ligne, avec NULL, est le total général. Affiche-la plus joliment avec COALESCE(statut, 'TOTAL').
Exercices corrigés
Entraîne-toi sur la base d’exemple. Cherche d’abord par toi-même, puis compare avec la solution.
Exercice 1 : le panier moyen de chaque client, arrondi à 2 décimales.
SELECT client_id, ROUND(AVG(montant), 2) AS panier_moyen
FROM commandes
GROUP BY client_id;Exercice 2 : le nombre de clients par ville, de la plus peuplée à la moins peuplée.
SELECT ville, COUNT(*) AS nb_clients
FROM clients
GROUP BY ville
ORDER BY nb_clients DESC;Exercice 3 : les mois où le chiffre d’affaires des commandes livrées dépasse 200 €.
SELECT DATE_FORMAT(date_commande, '%Y-%m') AS mois, SUM(montant) AS ca
FROM commandes
WHERE statut = 'livrée'
GROUP BY mois
HAVING SUM(montant) > 200;Exercice 4 : les clients qui ont au moins une commande annulée.
SELECT client_id
FROM commandes
GROUP BY client_id
HAVING SUM(statut = 'annulée') > 0; -- en MySQL, une condition vaut 1 ou 0Exercice 5 : le chiffre d’affaires livré par ville, villes sans commande comprises.
SELECT c.ville, COALESCE(SUM(m.montant), 0) AS ca
FROM clients AS c
LEFT JOIN commandes AS m
       ON m.client_id = c.id AND m.statut = 'livrée'
GROUP BY c.ville
ORDER BY ca DESC;Remarque : la condition sur le statut est placée dans le ON et non dans le WHERE. Dans le WHERE, elle éliminerait les clients sans commande (leur statut vaut NULL), et Namur disparaîtrait du résultat.
Exercice 6 : le meilleur client (le total le plus élevé).
SELECT client_id, SUM(montant) AS total
FROM commandes
GROUP BY client_id
ORDER BY total DESC
LIMIT 1;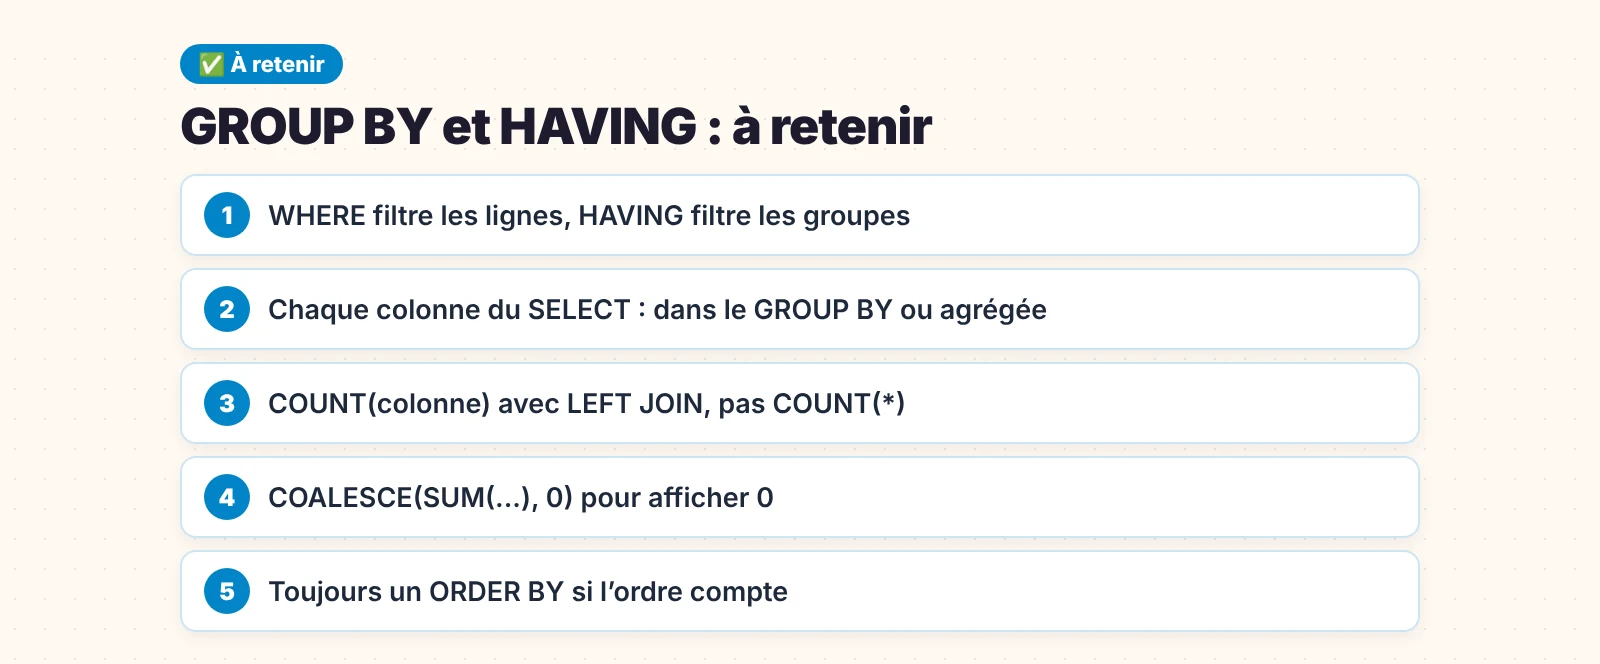
FAQ
Peut-on utiliser HAVING sans GROUP BY ?
Oui : toute la table forme alors un seul groupe. SELECT COUNT(*) FROM commandes HAVING COUNT(*) > 5 renvoie le nombre de commandes uniquement s’il dépasse 5. C’est rare en pratique.
Quelle différence entre GROUP BY et DISTINCT ?
SELECT DISTINCT ville FROM clients et SELECT ville FROM clients GROUP BY ville donnent le même résultat. Mais seul GROUP BY permet de calculer des agrégats par groupe (COUNT, SUM…). Utilise DISTINCT pour dédoublonner, GROUP BY pour résumer.
GROUP BY trie-t-il les résultats ?
Ne compte pas dessus. Les anciennes versions de MySQL triaient implicitement, ce n’est plus le cas depuis MySQL 8.0. Ajoute toujours un ORDER BY si l’ordre compte.
Comment accélérer une requête GROUP BY lente ?
Filtre au maximum dans WHERE, crée un index sur les colonnes du GROUP BY (et du WHERE), et ne sélectionne que les colonnes nécessaires. La commande EXPLAIN te montre si l’index est utilisé.
Conclusion
Avec GROUP BY et HAVING, tu passes de la simple lecture de données à leur analyse : GROUP BY forme les groupes, les fonctions d’agrégation les résument, WHERE filtre les lignes avant et HAVING filtre les groupes après. Retiens l’ordre d’exécution (FROM, WHERE, GROUP BY, HAVING, SELECT, ORDER BY), la règle de l’erreur 1055 et le piège du COUNT(*) avec LEFT JOIN, et tu éviteras 90 % des erreurs.
Pour pratiquer sur un projet complet, notre tutoriel SQL : créer la base de données d’une bibliothèque te propose un autre jeu de données sur lequel appliquer ces requêtes. La documentation MySQL sur les fonctions d’agrégation détaille toutes les fonctions disponibles.